
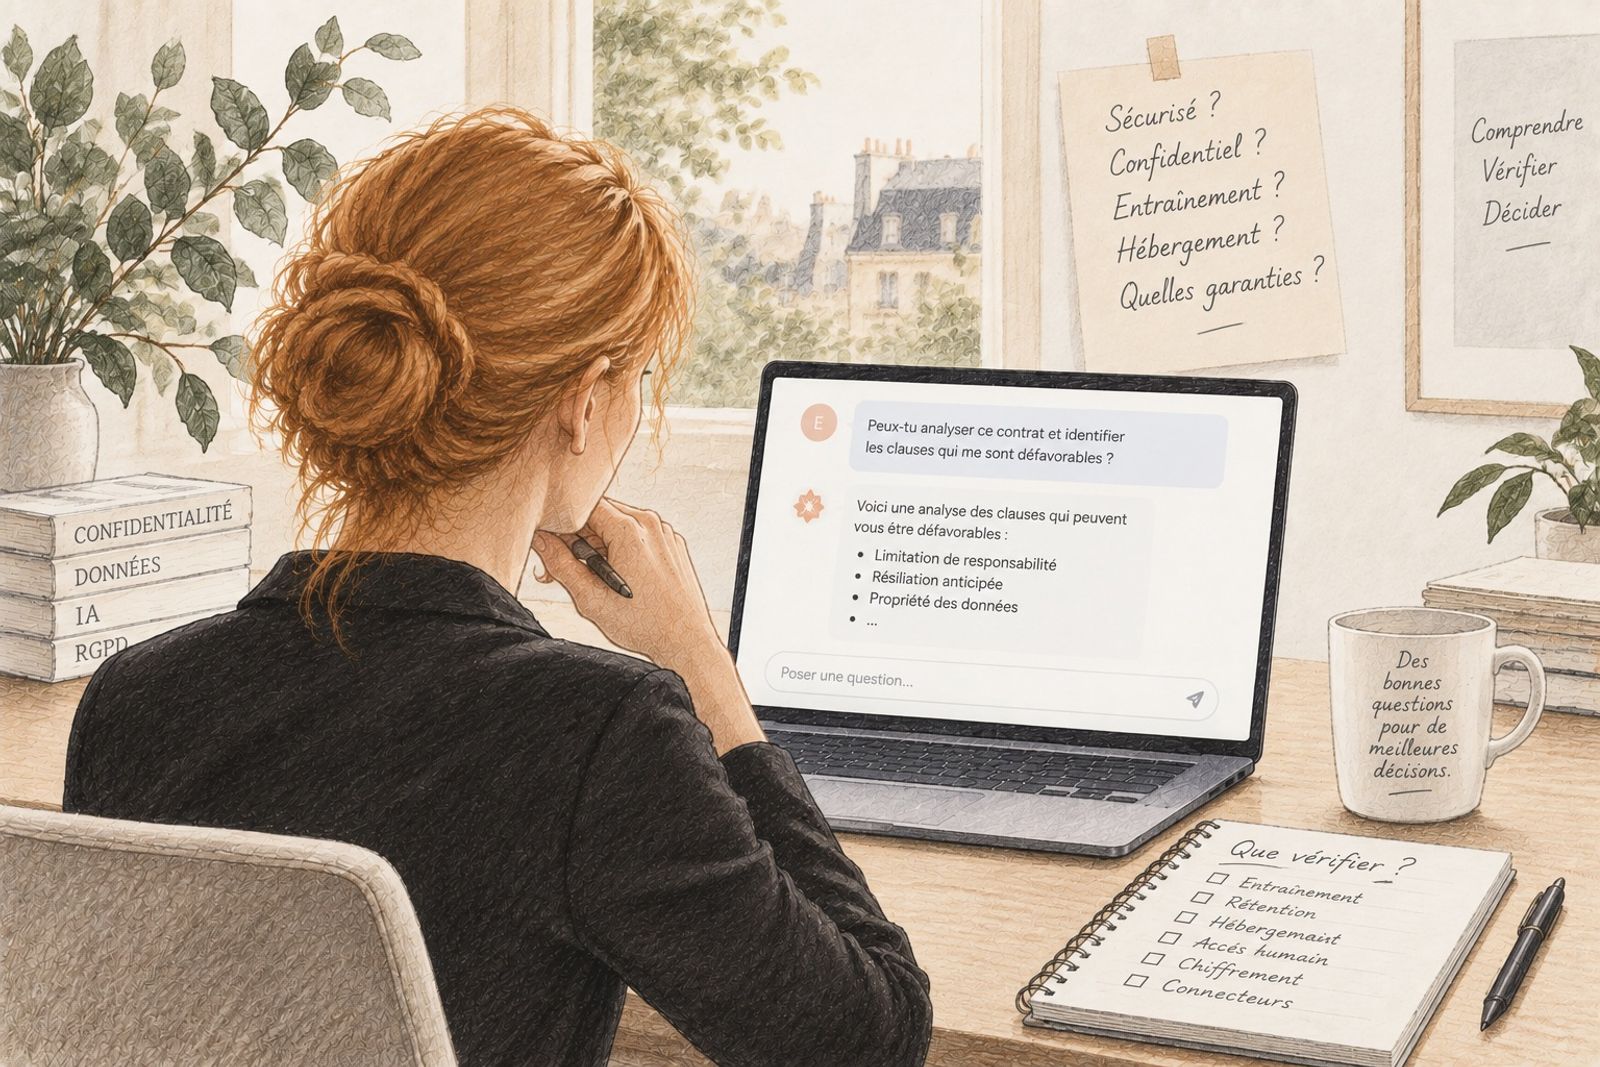
“Vos données sont sécurisées.”
“Elles restent confidentielles.”
“Elles ne sont pas utilisées pour entraîner nos modèles.”
“Elles sont chiffrées.”
On les lit partout.
Elles sont rassurantes, mais ce n’est pas suffisant.
D’ailleurs, elles ne disent pas toute la même chose.
Une donnée peut ne pas servir à l’entraînement d’un modèle et être néanmoins conservée. Elle peut être chiffrée et rester accessible au fournisseur dans certaines circonstances. Elle peut être stockée en Europe sans que cela signifie nécessairement que l’intégralité des traitements reste en Europe.
Alors, quand un fournisseur affirme que son outil est “sécurisé” ou “confidentiel”, que faut-il réellement comprendre et vérifier ?
C’est la question que je vous propose de décortiquer, affirmation par affirmation, avant de terminer par une liste de points à vérifier et, pour chacun, l’endroit où chercher la réponse.
Une précision avant de commencer : je ne parle ici que des offres professionnelles destinées aux entreprises et organisations. Les offres grand public obéissent à des conditions et à des paramétrages différents. C’est une distinction essentielle lorsque l’on utilise une IA dans un cadre professionnel.
Concrètement : si vous utilisez ChatGPT Plus ou Claude Pro au bureau avec un compte ouvert à votre nom, vous êtes dans le grand public, et cet article ne vous couvre pas.
Commençons par relativiser un peu le sujet
Confier des informations confidentielles à une entreprise technologique n’a pas commencé avec ChatGPT ou Claude.
Depuis des années, les entreprises stockent dans Microsoft 365 ou Google Workspace leurs contrats, leurs courriels, leurs documents RH, leurs dossiers contentieux, leurs budgets, parfois même leurs projets d’acquisition.
Ces informations sont donc déjà confiées à des infrastructures exploitées par des tiers, souvent des sociétés américaines.
Mais elles le sont dans un cadre : un contrat, un accord de traitement des données (le DPA de l’article 28 du RGPD), des paramétrages d’administration. C’est exactement ce cadre qu’il faut exiger d’une IA.
Le risque zéro n’existe pas. L’actualité récente nous rappelle régulièrement que même des organisations disposant de moyens considérables en matière de cybersécurité peuvent connaître des incidents.
Si l’existence d’un risque de compromission suffisait à interdire de confier une information confidentielle à un prestataire externe, il faudrait probablement commencer par cesser d’utiliser Microsoft 365, Google Workspace et, plus généralement, une grande partie des services cloud sur lesquels fonctionnent aujourd’hui les entreprises.
La bonne question n’est donc pas : “Existe-t-il un risque ?”
La réponse sera toujours oui.
Elle est plutôt : “Quelles garanties ai-je, quel risque subsiste et ce risque est-il acceptable compte tenu de ce que je veux confier à l’outil ?”
A propos de moi :
Comment les professions du droit peuvent-elles utiliser l’IA sans improviser, ni exposer leurs données ? Quels usages sont vraiment utiles ? Quels sont ceux qu’il faut bannir ?
Juriste depuis 25 ans, j’ai créé IAJuridique pour vous accompagner de façon pragmatique dans l’adoption concrète, utile et encadrée de l’IA : formation, conformité, choix d’outils et conduite de projet.
N’hésitez pas à me contacter
Mais une IA n’est pas tout à fait un espace de stockage
La comparaison avec Microsoft ou Google a néanmoins ses limites.
Lorsque vous déposez un contrat dans SharePoint ou Google Drive, vous demandez principalement au service de le stocker, de le synchroniser et éventuellement de permettre à d’autres personnes autorisées d’y accéder.
Lorsque vous déposez ce même contrat dans ChatGPT ou Claude en
demandant :
“Analyse ce contrat, identifie les clauses qui me sont défavorables et propose-moi une stratégie de négociation” ; en réalité, on demande autre chose.
Votre information devient un input et elle est traitée par le système qui produit un output. Autour de cet échange peuvent également exister un historique, des fichiers conservés, des journaux techniques, une mémoire, des projets ou encore des connecteurs vers d’autres applications.
Ces derniers méritent une attention particulière : ils donnent à l’IA accès, dans la limite des permissions accordées, à bien plus que ce que l’on aurait pensé lui copier-coller.
C’est d’ailleurs l’utilité même de l’IA qui nous encourage à lui donner du contexte.
Un contrat, puis ses annexes, puis les échanges avec le cocontractant, puis nos commentaires internes et peut-être même plusieurs contrats pour les comparer.
C’est pourquoi il devient nécessaire de savoir ce que devient l’information confiée à une IA.
“Vos données ne servent pas à entraîner nos modèles “
C’est probablement la première affirmation à rechercher.
OpenAI indique que les données des offres professionnelles concernées ne sont pas utilisées par défaut pour entraîner ses modèles. Anthropic formule également cet engagement pour ses produits commerciaux.
C’est une garantie importante.
C’est aussi une garantie difficile à vérifier de l’extérieur. Le Conseil national des barreaux (CNB) relève dans son guide d’avril 2026 que cette affirmation “n’est en général ni prouvable ni vérifiable”. Raison de plus pour la lire dans un contrat plutôt que sur une page marketing, j’y reviendrai.
Elle comporte aussi une exception peu connue : le pouce levé ou baissé. Chez Anthropic, lorsqu'un utilisateur note une réponse, la conversation entière est transmise, conservée jusqu'à cinq ans et peut servir à entraîner les modèles, y compris dans les offres Team et Enterprise où l'entraînement est exclu par défaut ; l'administrateur peut désactiver cette fonction. Chez OpenAI, la même règle est documentée pour les offres grand public ; la documentation de ChatGPT Business et Enterprise ne mentionne pas d'exception.
Mais elle ne répond qu’à une seule question : mes données vont-elles servir à améliorer ou entraîner les modèles du fournisseur ?
Elle ne nous dit pas combien de temps elles sont conservées.
Elle ne nous dit pas quelles données techniques peuvent subsister.
Elle ne nous dit pas dans quelles circonstances un accès humain peut être possible.
Elle ne nous dit pas où elles sont stockées.
Et elle ne nous dit évidemment pas qu’une compromission est impossible.
Pas d’entraînement ne signifie donc pas absence de conservation. Et encore moins absence de risque.
Combien de temps mes données sont-elles conservées ?
Deuxième question : la rétention. Et c’est là que les choses deviennent rapidement moins simples.
La durée de conservation peut dépendre du fournisseur, mais également de l’offre souscrite, du type de donnée et des paramètres définis par l’organisation.
Certaines offres Enterprise permettent par exemple à l’entreprise de définir des politiques de rétention personnalisées. Ces possibilités ne sont pas nécessairement identiques dans les offres professionnelles plus accessibles aux petites structures (Team pour Claude et Business pour ChatGPT).
Donc, la bonne question à se poser devient : “Combien de temps l’offre à laquelle j’ai souscrit, avec cette configuration, conserve-t-elle ce type de donnée ?”
Il faut alors regarder séparément, lorsque cela est pertinent, les conversations, les fichiers, les outputs, les logs ou les données nécessaires à la sécurité du service.
À la date où j’écris ces lignes, ChatGPT Business et Claude Team suivent une logique proche : conversations et fichiers sont conservés, sans durée prédéfinie, tant que l’utilisateur ne les supprime pas, afin qu’il retrouve son historique.
Chez les deux fournisseurs, les offres Enterprise permettent d’aller plus loin en définissant des durées de conservation personnalisées avec, chez Anthropic, une durée minimale de 30 jours. Attention toutefois : tant qu’aucune durée n’est paramétrée, les données restent conservées sans limite. La fonctionnalité existe, encore faut-il l’activer.
Autrement dit, lire que “vos données sont protégées” ou qu’elles “ne servent pas à l’entraînement” ne vous renseigne pas sur leur durée de conservation.
Il est donc indispensable de vérifier les garanties dont vous disposez réellement, et non celles que le fournisseur est techniquement capable de proposer.
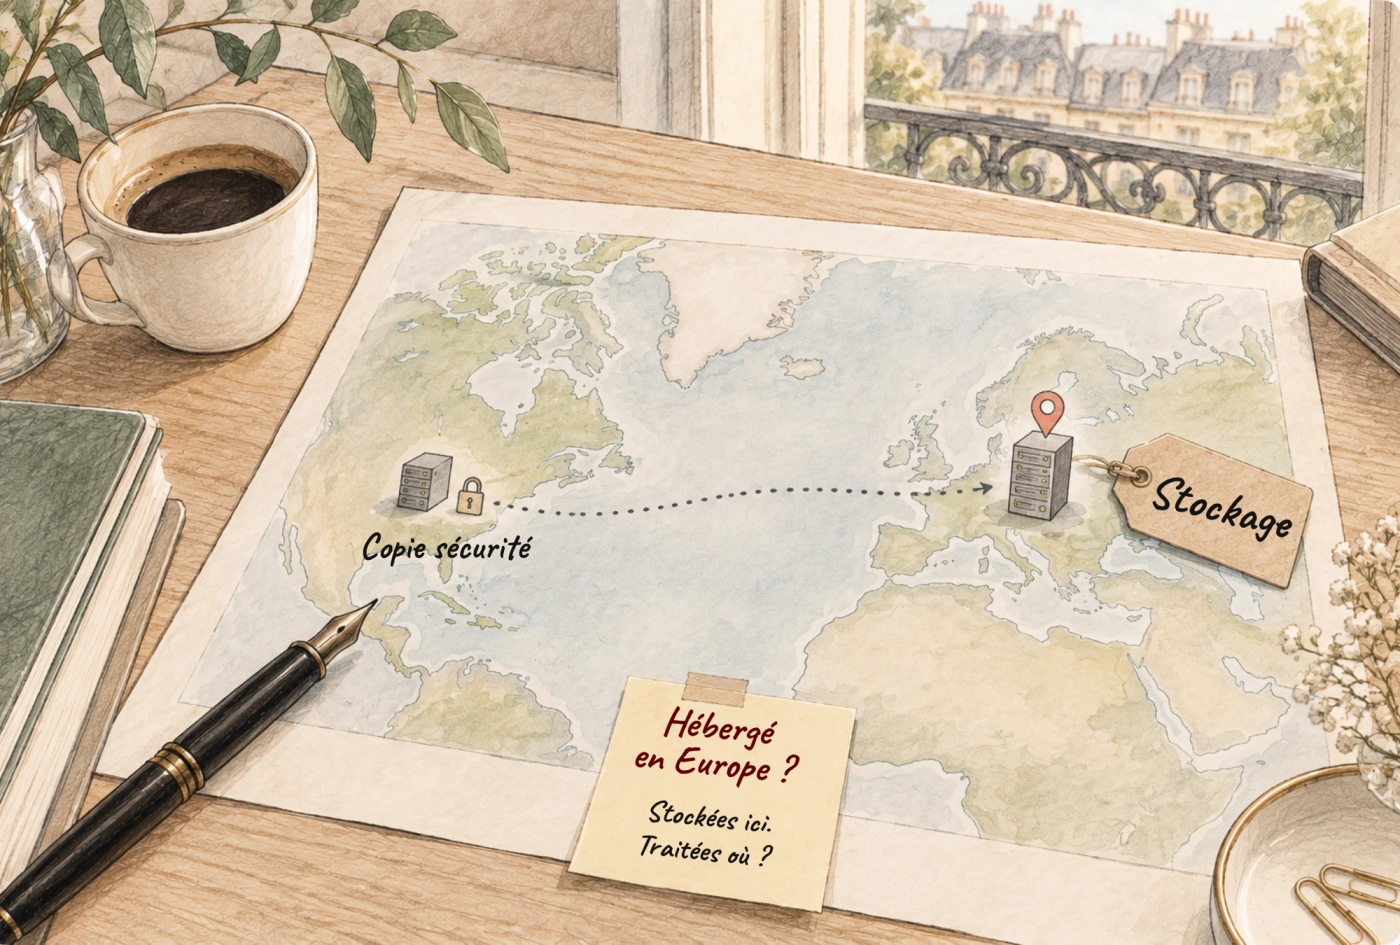
« Vos données sont hébergées en Europe »
Voilà encore une affirmation qui paraît simple.
Elle l’est beaucoup moins lorsqu’on commence à la regarder de près.
Quelles données sont concernées ? Les conversations ? Les fichiers ? Les outputs ? Les journaux techniques ? Les données nécessaires à la détection des abus ?
Et parle-t-on du lieu où les données sont stockées, ou également de celui où elles sont traitées ?
La localisation européenne est évidemment importante, notamment au regard du RGPD et des transferts internationaux. Mais il ne faut pas en déduire davantage.
En particulier, stocker une donnée en Europe auprès d’une entreprise américaine ne signifie pas nécessairement qu’elle échappe à toute demande d’une autorité américaine. Le CLOUD Act prévoit qu’un fournisseur soumis à la juridiction américaine peut, dans le cadre d’une procédure légale valide, être tenu de communiquer des données qui sont sous sa possession, sa garde ou son contrôle, indépendamment du lieu où elles sont stockées.
OpenAI l’illustre d’ailleurs très concrètement :
Pour ChatGPT Business, le choix d’une région de résidence détermine où le contenu principal de l’espace de travail est stocké au repos. Mais OpenAI précise que, lorsqu’une région hors États-Unis est choisie, une copie de chaque requête et de chaque réponse est tout de même conservée aux États-Unis “pour une durée limitée”, à des fins de sécurité et de surveillance des abus, et que la région choisie ne détermine pas le lieu où les requêtes sont traitées et les réponses générées.
Autrement dit, héberger ses données en Europe ne suffit pas à les soustraire au droit américain.
C’est une information importante à connaître, sans pour autant en déduire que les autorités américaines peuvent librement accéder aux données : un tel accès suppose une procédure légale et le respect des conditions qui lui sont applicables.
“Personne ne lit vos conversations”
Les fournisseurs conservent une copie des échanges à des fins de sécurité, on vient de le voir chez OpenAI. C'est le point d'entrée d'une question que les pages marketing éludent : celle de l'accès humain.
La surveillance des usages abusifs est d’abord automatisée, mais les contenus signalés peuvent être revus par des équipes habilitées ; le support technique et les demandes des autorités sont deux autres cas d’accès possibles. Ce n’est pas un scandale, c’est le fonctionnement normal d’un service en ligne.
Mais c’est une information à chercher dans la documentation, et le CNB en fait à juste titre un critère : impossibilité d’accès pour les salariés du fournisseur ou, à défaut, habilitations strictes et journalisation des accès.
“Vos données sont chiffrées”
Mais là encore : chiffrées quand, et qu’est-ce que cela protège exactement ?
Deux expressions reviennent dans la documentation des fournisseurs :
- le chiffrement en transit, qui protège les données lorsqu’elles circulent, par exemple entre votre ordinateur et les infrastructures du fournisseur.
- et le chiffrement au repos, qui protège les données lorsqu’elles sont stockées.
Ce sont des protections importantes. OpenAI indique par exemple actuellement utiliser un chiffrement AES-256 pour les données au repos et TLS 1.2 ou supérieur pour les données en transit.
Mais attention à ce que l’on en déduit : “mes données sont chiffrées” ne signifie pas que le fournisseur est techniquement incapable d’y accéder.
Pour fournir le service demandé, certaines données doivent pouvoir être déchiffrées et traitées.
Certaines offres Enterprise donnent au client davantage de contrôle sur les clés de chiffrement (l’Enterprise Key Management chez OpenAI, par exemple) ; le CNB en fait d’ailleurs un critère : une clé détenue et gérée par le cabinet.
Mais, pour la plupart des entreprises, la question essentielle reste plus simple : Quand un fournisseur m’annonce une mesure de sécurité, qu’est-ce qu’elle protège exactement ?
Une faille reste toujours possible
Même après avoir coché toutes ces cases, il reste une réalité assez banale : aucun système informatique n’est invulnérable.
OpenAI, Anthropic, Microsoft ou Google investissent massivement dans leur sécurité, et ils y ont un intérêt majeur compte tenu de la nature de leur activité. Ces mesures réduisent le risque ; elles ne l’annulent pas.
L’enjeu n’est donc pas d’obtenir du fournisseur la promesse impossible qu’aucun incident ne surviendra jamais.
Il est de vérifier que les mesures mises en œuvre sont adaptées au niveau de risque que l’on accepte.
C’est ici que la nature des informations compte.
Faire analyser les conditions générales d’un fournisseur disponibles publiquement n’est pas la même chose que transmettre le dossier d’une acquisition non annoncée, un secret industriel stratégique ou l’intégralité d’un dossier contentieux.
La confidentialité n’est donc pas seulement une propriété de l’outil. Elle résulte de la rencontre entre les garanties de l’outil, son paramétrage, la sensibilité de l’information et l’usage que vous en faites.
Et si je suis juriste d’entreprise ?
Le juriste d’entreprise n’est pas tenu au secret professionnel de l’avocat, mais il manie chaque jour des informations couvertes par des clauses de confidentialité.
Déposer dans un outil tiers un contrat reçu sous NDA, est-ce une “communication à un tiers” au sens de cette clause ? Beaucoup de NDA ne disent rien des prestataires informatiques, ou ne les autorisent que s’ils sont tenus à des obligations équivalentes. Le DPA et les engagements de confidentialité du fournisseur deviennent alors la pièce à produire le jour où la question est posée.
S’y ajoutent, dès que des données personnelles sont en jeu, les obligations propres de l’entreprise : le fournisseur d’IA est en principe un sous-traitant au sens de l’article 28 du RGPD, ce qui suppose un contrat conforme, l’inscription du traitement au registre et, pour certains usages, une analyse d’impact.
Et si je suis avocat ?
Pour l’avocat, une exigence supplémentaire s’ajoute évidemment : le secret professionnel.
Le CNB a adopté en mars 2026 la première édition de son guide pratique “La déontologie et l’intelligence artificielle”, qui actualise ses recommandations antérieures.
Sa position est nette, et plus stricte que ce que l’on entend souvent : “il est impératif pour l’avocat de veiller à ne jamais communiquer des données relatives à ses dossiers ou à ses clients à des intelligences artificielles génératives”. Nom du client, informations confidentielles, éléments de stratégie, fichiers d’un dossier : rien de tout cela ne doit figurer dans une requête ; la voie recommandée est la pseudonymisation ou l’anonymisation, avec un contexte limité au strict nécessaire.
Sur le choix des outils, il renvoie à sa grille d’auto-évaluation de juin 2025 et fixe des critères de souveraineté : hébergement des données et du modèle en France ou dans l’Union, par un hébergeur non soumis à une législation extraterritoriale (les entreprises américaines sont explicitement visées).
Lu strictement, ce passage exclut la transmission directe à une IAG de données couvertes par le secret professionnel, quelle que soit l’offre souscrite. Le guide raisonne toutefois sur “l’IAG” en général, sans distinguer les offres grand public des offres professionnelles assorties d’un DPA, de contrôles d’administration ou d’une résidence des données. C’est précisément la distinction que cet article essaie d’examiner, et un débat que la profession devra, je crois, avoir.
Le même guide propose une clause de convention d’honoraires, reprise dans les modèles types du CNB d’avril 2026, dont la formulation est plus souple : aucune information confidentielle ou sensible ne sera transmise à un outil ne présentant pas des garanties suffisantes de confidentialité.
La question devient alors particulièrement intéressante : qu’est-ce qu’une garantie “suffisante“ de confidentialité ?
Le guide lui-même en donne les critères (chiffrement avec une clé détenue par le cabinet, non-réutilisation des données, suppression des requêtes après réponse, habilitations d’accès journalisées, certifications), qui recoupent la liste qui suit. Mais une garantie « suffisante » ne peut probablement pas être appréciée indépendamment de l’outil, de son contrat, de son paramétrage et de la nature des informations concernées.
Alors, que faut-il vérifier ?
Avant de considérer qu’un outil professionnel est suffisamment confidentiel pour votre usage, je regarderais au minimum les dix points suivants, en indiquant à chaque fois où chercher la réponse :
- Entraînement : mes données sont-elles utilisées pour entraîner ou améliorer les modèles ? Où chercher : le DPA ou les conditions commerciales, pas la page marketing.
- Rétention : combien de temps conversations, fichiers et autres données sont-ils conservés ? Où chercher : le centre d’aide ou de confidentialité du fournisseur, puis la console d’administration de votre espace.
- Accès : dans quelles circonstances le fournisseur ou ses sous-traitants peuvent-ils accéder aux données ? Où chercher : la politique de confidentialité et la documentation sécurité (Trust Center) ; le rapport SOC 2, sur demande.
- Connecteurs et mémoire : quelles applications l’outil peut-il lire, et qui l’a autorisé ? Où chercher : la console d’administration (connecteurs activés, mémoire, projets partagés).
- Localisation et transferts : où sont-elles stockées et traitées, et quels mécanismes encadrent les éventuels transferts ? Où chercher : la page de résidence des données, la liste des sous-traitants et les clauses de transfert du DPA (Data Privacy Framework ou clauses contractuelles types).
- Chiffrement : quelles protections existent en transit et au repos ? Où chercher : le Trust Center ; la gestion des clés par le client n’est généralement proposée qu’en Enterprise.
- Sous-traitants : quels autres prestataires interviennent dans le traitement ? Où chercher : la liste publique des sous-traitants. Les modèles tournent chez Amazon, Google ou Microsoft, ce qui compte aussi pour la localisation.
- Suppression : que se passe-t-il réellement lorsque je supprime une conversation ou un fichier ? Où chercher : le centre d’aide (délai d’effacement effectif, sauvegardes, exceptions légales).
- Offre souscrite : les garanties annoncées sont-elles réellement comprises dans mon abonnement ? Où chercher : la grille tarifaire, comparée à ce que votre console d’administration permet réellement d’activer.
- Contrat : enfin, où ces garanties sont-elles écrites : page marketing, documentation technique, DPA ou engagement contractuel opposable ?
Car c’est probablement la dernière question qui intéressera le plus le juriste.
Une promesse commerciale, une caractéristique technique et un engagement contractuel ne sont pas la même chose.
Accepter un risque ne signifie pas l’ignorer
La réponse n’est donc ni :
“J’ai une offre professionnelle, je peux tout mettre dans mon IA. “
ni :
“Une fuite est toujours possible, je ne dois jamais lui confier aucune information confidentielle.”
Nous acceptons déjà quotidiennement un risque résiduel en confiant nos informations à Microsoft, Google ou d’autres fournisseurs cloud ; l’IA générative oblige simplement à refaire ce raisonnement en tenant compte de ses particularités.
En conclusion, l’objectif n’est donc pas de trouver une IA “sans risque”. Il faut savoir quelles garanties elle offre, comprendre leurs limites et décider en connaissance de cause ce qu’on accepte de lui confier.